
中转站给你的到底是不是真 GPT?两个开源项目帮你验一验
用中转站的朋友,多半都犯过这个嘀咕:
我花钱买的 GPT,后台给我的真是 GPT 吗?
会不会悄悄换成便宜的小模型,价格照收?
我之前的办法很笨:新开一个对话,先问一句"你的训练数据截止到哪天"。
翻了下我的 Codex 记录,光问这一句的对话就有 14 个。
后来我才想明白,这招基本没用。
为什么问截止日期没用
模型说自己是谁、知识截止到哪天,靠的是它"记得"什么,再加上系统提示词告诉它什么。
说白了,这是让嫌疑人自己报身份证号。
中转站要是真想换模型,在系统提示词里加一句"你是 GPT",小模型也能对答如流。反过来,真模型也可能记错自己的截止日期。
所以问题变成了:有没有办法,不听它怎么说,只看它怎么做?
最近 GitHub 上有两个项目,给出了一个挺巧的答案。
两个项目:ModelTrace 和 lm-detector
ModelTrace
作者 xqy2006,8 月底开源,MIT 协议。截至 10 月 20 日,大约 1800 星。
核心算法用 Python 写,本地跑一个网页;另有一个不用后端的纯网页版,可以手动粘贴回答来测。
lm-detector
作者 Ikaleio,9 月中开源,MIT 协议。截至 10 月 20 日,大约 700 星。
TypeScript 写的,有在线网页,也有命令行工具,npx 一行就能跑。
它的 README 里写明了:算法思路和部分原始数据参考自 ModelTrace。所以这俩可以看成一个思路的两种实现。
原理:让模型写 300 个"随机数"
两个项目的核心思路一样:
让模型凭第一反应,写出一串 1 到 355 之间的整数,大约 300 个。
你可能觉得,随机数嘛,谁写都差不多。
其实不是。
语言模型写出来的"随机数"一点都不随机。每个模型都有自己偏爱的数字、偏爱的区间、偏爱的末位数字,而且这种偏好相当稳定。
就像每个人写字都有自己的笔迹。让你随便写 300 个数字,你写出来的也会带着你的习惯。
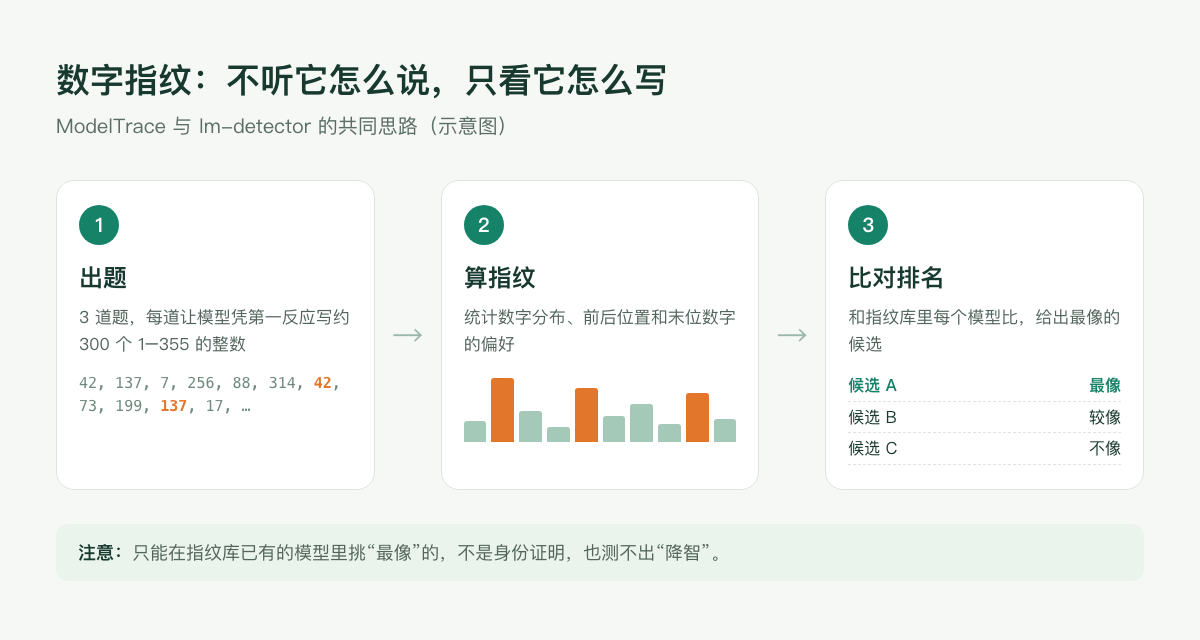
检测流程大概是这样:
- 出题:发 3 道题给待测模型,每道都要求写约 300 个整数,不许用工具、不许按规律递增
- 算指纹:统计这些数字的分布,再看前后不同位置、末位数字的偏好
- 比对:和事先采集好的"指纹库"挨个比,看最像哪个模型
- 出结果:给出一个排名,和每个候选的置信度
这道题的妙处在于:它和语义无关。
系统提示词可以教模型说"我是 GPT",但很难教会一个小模型,把数字偏好也模仿得和 GPT 一模一样。
两个项目有什么区别
指纹库覆盖面
ModelTrace 目前收录 18 个模型,只有 GPT 和 Claude 两个家族。
lm-detector 覆盖面大得多。它的数据记录里写着,参考库已有 60 个指纹身份。
除了 GPT、Claude,还有 Gemini、Grok、Qwen、DeepSeek 等。
接口协议
两个都支持 Chat Completions 和 Anthropic Messages 格式;lm-detector 额外支持 OpenAI 的 Responses 接口。
特色功能
ModelTrace 带了一个 Codex 插件 ModelTrace Guard,能在你的 Codex 任务进行中,在后台定期抽查。
连续复测都不一致时,它会停下原任务。
lm-detector 有命令行实时界面、多轮检测、JSON 输出。
还有一个可选的"分词器探测":从接口返回的 token 用量,反推上游用的是哪种分词器。
一句话选:
主要测 GPT、Claude,或者想接进自己的 Python 工具,用 ModelTrace。
要测的模型种类多,或者想在命令行里直接跑,用 lm-detector。
怎么测你的中转站
最省事的是 lm-detector 的网页:打开 lm.ikale.io,选 API 模式,填中转站的接口地址、Key 和模型名,点开始。
这里有个坑要注意。
网页的"连接方式"默认是"本站代理":你的 Key、题目和模型的回答,会经过检测网站的服务器再转到中转站。
它的连接方式文档写得很坦白,这是因为很多中转站不允许网页直接调用,只能走代理。
介意的话,有三个办法:
- 连接方式改成"直连",前提是你的中转站允许网页直接访问
- 用命令行版,请求从你自己电脑直接发出
- 测完换一个新 Key
命令行版需要 Node.js 22 以上,一行就能跑:
npx lmfpd@latest -b 你的中转站地址/v1 -k 你的Key -m gpt-6-astraModelTrace 也可以本地运行:装好依赖后 python start.py,浏览器打开本机 7860 端口,填同样三项就行。
它的说明里写了,API Key 只用于当次请求,不写入磁盘。
我拿自己的官方号测了一下
我自己有个小工具包 sd-spider-utils,里面有一个看 Codex 额度的终端面板。我把 ModelTrace 的评分核心接了进去,加个参数就能顺手测一下模型指纹。
我固定只测一个配置:gpt-6-astra,推理强度 ultra,走 Codex 官方订阅通道。
10 月 17 日,我拿 3 个官方订阅号并发测了一轮,每个号 3 道题:
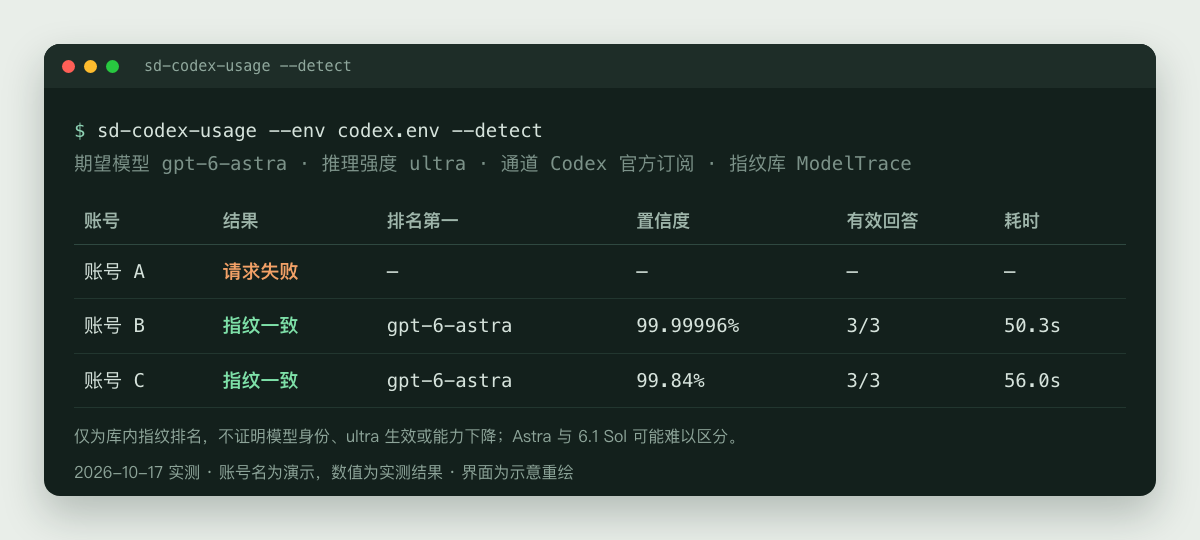
- 两个号:排第一的都是 gpt-6-astra,置信度分别约 99.99996% 和 99.84%
- 一个号:模型请求失败,这次没有结果,不算数
- 每个号测一轮 50 多秒,用了约 1.7 万输入 token、4000 多输出 token
截图里的账号名是演示用的,数字是那天的实测结果。
注意,这是官方号,相当于一个"标准答案"的参照。
我还没拿中转站测过,所以这里不下"某家中转站是真是假"的结论。你可以拿自己的中转站去测,和这个结果对照着看。
另外,检测本身要真的让模型写数字,会消耗额度。 我的面板平时只显示上次的结果,加了参数才重新测。
它能测什么,测不了什么
这部分最重要。两个项目自己的说明都写得很清楚,我归纳成四条:
1. 只能在"库里"挑最像的
它是闭集排名:只会在指纹库已有的模型里,挑一个最像的。
如果中转站给你的是一个库里没有的模型,它照样会给你一个"最像"的结果,而且置信度可能还挺高。
2. 有的模型本来就分不开
lm-detector 已经把 gpt-6-astra 和 gpt-6.1-sol 合并成了同一个指纹类别,明确说靠数字指纹没法可靠区分。
所以测出 Astra,也不能说明对面一定不是 6.1 Sol。
3. 测的是"换没换模型",不是"降没降智"
如果中转站没换模型,只是偷偷调低了推理强度、砍了上下文,指纹大概率测不出来。
我的面板也只敢标"指纹一致",不敢标"没降智"。
想测"变笨了没有",得另外准备一套有标准答案的题目,固定参数,和历史成绩对比。这是另一件事。
4. 别在 Claude Code 里测
ModelTrace 的说明里提到,Claude Code 的系统提示词会严重影响模型的数字偏好,在里面测结果偏差很大。
另外,两个项目同源,同时测出一样的结果,也不能当成两份独立证据。
总结
问模型"你是谁",它说什么都行。
让它写 300 个数字,它很难装。
这是我目前见过最实用的"验货"办法:怀疑中转站换了模型,花一点额度测几轮,心里就有个数。
但也别把那个百分比当判决书。它告诉你的是"最像谁",不是"一定是谁",更不是"有没有降智"。
固定参数、多测几轮、结合平时的使用体验,再下判断。
你用的中转站测过吗?结果怎么样?评论区聊聊。
参考链接
- ModelTrace(GitHub)
- lm-detector(GitHub)
- lm-detector 在线检测 · 文档 · 原理 · 连接方式 · 数据记录
- ModelTrace Guard(Codex 插件)
- sd-spider-utils(PyPI)
项目 Star 数和指纹库规模为 2026-10-20 查看时的数据,两个项目更新很快,以仓库最新说明为准。
