
开源项目 · 爬虫案例
Spider-Project 爬虫实操合集
从一个小需求开始,把爬虫跑通。
把自己学习过程中做过的爬虫项目整理在一起:B站弹幕、抖音视频、公众号文章、知乎评论、七猫榜单、wallhaven、问卷星等,尽量用简单的代码把需求跑通。
- 类型
- 爬虫案例合集
- 技术
- requests / Selenium / lxml / pandas
- 难度
- 入门友好
- 内容
- 20+ 个小项目
适合什么样的学习
这个仓库刻意避开了 Scrapy 框架和多线程:每个小项目基本都是 requests / Selenium 加解析和存储,逻辑直白,适合刚开始做完整爬虫、或者需要交课程作业的人。
它不追求工程化,重点在于“看到一个页面,知道从哪里开始拆”。项目多了以后,你会发现自己反复用的其实是同一套流程:找数据来源、模拟请求、解析字段、保存、做一点分析。
收录的项目
- 视频与弹幕:B站弹幕词云、何同学视频弹幕词云、一键获取热点事件弹幕、虎牙视频
- 内容平台:抖音无水印视频、公众号文章、知乎评论、每日一文、七猫小说排行榜
- 图片与工具:wallhaven 图片、问卷星批量填写、一言生成短语、中国省份城市映射表
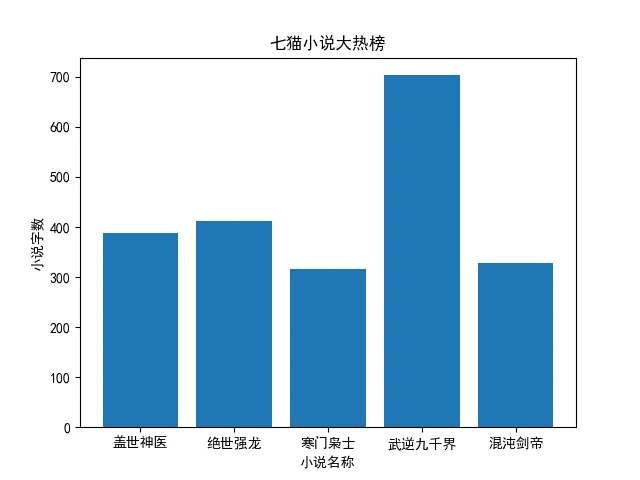
- 数据与分析:澎湃新闻标题、虎嗅新闻标题、原子回声问答对,以及七猫榜单的可视化
怎么跑
bash
git clone https://github.com/cpython666/Spider-Project.git
cd Spider-Project
python -m venv venv
source venv/bin/activate  # Windows: venv\Scripts\activate
pip install requests selenium lxml pandas每个项目在独立目录里,进入对应目录运行其中的脚本即可。需要浏览器的项目要准备好 Chrome / ChromeDriver;需要登录态的项目,按脚本里的注释替换 Cookie 或账号配置。
使用边界
目标网站会改版,几年前的代码不能保证今天还能直接跑;遇到 404、字段为空或验证码,先检查页面结构再改解析。所有项目仅用于学习和技术交流,请遵守目标站点的 robots 规则、服务条款和当地法律,不要用于批量抓取隐私数据或商业侵权。
相关入口
开源项目
喜欢这页纸,就去 GitHub 点个 Star。
问题、建议或想要的功能,欢迎在仓库里提 Issue。
